Künstliche Intelligenz kann komplexe Software entwickeln, wissenschaftliche Texte zusammenfassen und schwierige Fragen beantworten. Aber ob Oman ein Land ohne A im Namen ist? Da wird es manchmal schwierig. Warum ausgerechnet das harmlose Gesellschaftsspiel Stadt-Land-Fluss die Schwächen von Sprachmodellen offenlegt, hat einen überraschend technischen Hintergrund.
Stadt, Land, Fluss – das kann doch nicht so schwer sein?
Stell dir vor, du spielst mit Freunden eine Runde Stadt-Land-Fluss next Level. Ihr spielt nicht nur nach Anfangsbuchstaben, sondern mit Zusatzregeln. Gesucht sind Begriffe, die mit O beginnen und kein A enthalten.
Du überlegst, welches Land beginnt mit einem O, enthält aber kein A…
Oman scheidet aus.
Nach dem Spiel fragst du deine Lieblings-KI nach passenden Ländern. Und plötzlich behauptet sie, dass Oman die Bedingungen erfüllt.
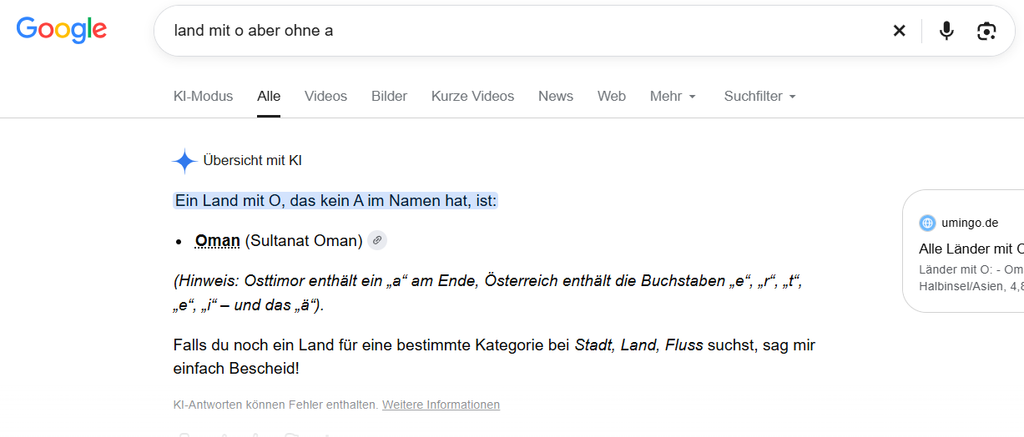
Moment mal. Eine KI, die ganze Anwendungen programmieren kann, übersieht einen Buchstaben in einem Wort mit gerade einmal vier Zeichen?
Das klingt absurd, ist aber ein schönes Beispiel dafür, das KIs (die sogenannten „Großen Sprachmodelle“ / LLMs) ganz anders funktionieren, als die meisten von uns annehmen.
Und es erklärt, warum ich ein Stadt-Land-Fluss-Spiel nicht unbedingt einer KI als Schiedsrichter anvertrauen würde.
Warum Stadt-Land-Fluss für eine KI schwieriger ist, als es aussieht
Eigentlich ist Stadt-Land-Fluss doch gar nicht so kompliziert.
Man muss Begriffe in verschiedenen Kategorien finden, die mit einem bestimmten Buchstaben beginnen. Vielleicht hat man noch ein paar extra Regeln, wie z. B. dass ein bestimmter Buchstabe nicht in den Begriffen vorkommen darf.
Für einen Menschen ist das meist keine große Herausforderung. Wir erkennen auf den ersten Blick die Buchstaben eines Wortes und wissen in vielen Fällen, ob es sich um eine Stadt, ein Land oder einen Fluss handelt.
Ein Sprachmodell hat allerdings gleich mehrere Aufgaben zu bewältigen:
- Es muss einen passenden Begriff finden.
- Es muss erkennen, ob dieser zur gesuchten Kategorie gehört.
- Es muss überprüfen, ob der Anfangsbuchstabe stimmt.
- Es muss gegebenenfalls zusätzliche Regeln berücksichtigen.
- Es sollte möglichst keine Orte erfinden, die gar nicht existieren.
Gerade die Überprüfung einzelner Buchstaben kann überraschend fehleranfällig sein.
Denn Sprachmodelle lesen Wörter nicht auf dieselbe Weise wie wir.
Das Problem sind die Tokens
Wenn du das Wort „Oman“ liest, siehst du vier Buchstaben:
O – m – a – n
Du kannst sie einzeln betrachten, zählen und miteinander vergleichen.
Ein Sprachmodell verarbeitet Text dagegen zunächst in sogenannten Tokens.
Bevor der Text das neuronale Netz der KI erreicht, zerlegt ein sog. Tokenizer ihn in kleinere Einheiten. Diese Tokens können vollständige Wörter, Wortbestandteile, einzelne Zeichen oder auch Satzzeichen sein.
Ein längeres Wort könnte beispielsweise in mehrere Bestandteile zerlegt werden, während ein häufig vorkommendes kurzes Wort möglicherweise nur ein einziges Token benötigt.
Die genaue Zerlegung hängt vom verwendeten Tokenizer ab – unterscheidet sich also von KI zu KI und von Sprachmodell zu Sprachmodell.
Anschließend werden die Tokens durch Zahlen (genauer: numerische IDs) repräsentiert.
Das Entscheidende daran:
Ein Token entspricht nicht zwangsläufig einem Buchstaben.
Wenn ein Wort als einzelnes Token verarbeitet wird, bekommt das Sprachmodell seine einzelnen Buchstaben oft gar nicht mit. Das was uns als Wort erscheint, ist für die Künstliche Intelligenz nur eine Nummer.
Das heißt allerdings nicht, dass die KI überhaupt nicht weiß, wie das Wort zusammengesetzt wird.
Während des Trainings kann sie durchaus gelernt haben, wie ein Wort geschrieben wird. Sie kann Wörter buchstabieren und sogar komplexe Zeichenanalysen durchführen.
Nur ist dieses Wissen nicht unbedingt so zuverlässig verfügbar wie bei einem Algorithmus, der eine Zeichenkette direkt untersucht.
Die KI weiß, wo Oman liegt – aber nicht unbedingt, welche Buchstaben darin vorkommen
Das ist das eigentlich Kuriose.
Frage eine KI nach dem Oman und sie kann dir vermutlich eine Menge erzählen.
Sie weiß, dass das Land auf der Arabischen Halbinsel liegt, dass Maskat seine Hauptstadt ist und dass es an das Arabische Meer grenzt, und und und…
Sie kann dir vielleicht sogar eine Reiseroute zusammenstellen oder dir etwas über die Geschichte des Landes erzählen.
Aber die Frage, ob der Name den Buchstaben A enthält, kann sie unter Umständen falsch beantworten.
Wie passt das zusammen?
Ein „Großes Sprachmodell“ (Large Language Model) ist darauf trainiert, Muster und Zusammenhänge in großen Mengen von Text zu lernen. Es hat dadurch enormes Wissen über Länder, Städte und Flüsse.
Das bedeutet jedoch nicht, dass es zu jedem bekannten Begriff eine exakt abrufbare Liste seiner Buchstaben besitzt.
Man könnte sagen: Die KI weiß eine Menge über Oman, muss aber bei der Frage nach den einzelnen Buchstaben seines Namens eine ganz andere Fähigkeit einsetzen.
Und genau diese Fähigkeit ist nicht immer zuverlässig.
Warum ein simpler Algorithmus manchmal besser ist als künstliche Intelligenz
Als Softwareentwickler finde ich daran besonders interessant, wie einfach sich manche dieser Aufgaben mit klassischer Programmierung lösen lassen.
Nehmen wir unsere Zusatzregel aus dem Stadt-Land-Fluss-Spiel:
Finde Länder, die mit O beginnen und kein A enthalten.
Wenn wir bereits eine Liste mit Ländernamen haben, lässt sich diese Aufgabe mit wenigen Zeilen PHP lösen:
$countries = [
    'Oman',
    'Österreich',
    'Osttimor'
];

$result = array_filter(
    $countries,
    fn($country) =>
        str_starts_with($country, 'O')
        && stripos($country, 'a') === false
);

print_r($result);
Das Ergebnis ist eindeutig: Die einzig korrekte Antwort ist „Osttimor“. (Auch wenn unter gewissen Bedingungen das Ö wie ein O behandelt wird (in einem Lexikon zum Beispiel), sind Ö und O in der Softwareentwicklung zwei völlig unterschiedliche Zeichen.)
Und genau deshalb ist es wichtig, Ergebnisse tatsächlich zu prüfen, statt sich auf eine plausibel klingende Erklärung zu verlassen.
Ein korrekt ausgeführter Algorithmus findet Osttimor zweifelsfrei und zuverlässig, wohingegen ein großes Sprachmodell bei dieser Aufgabe unzuverlässig ist.
Sobald diese Voraussetzungen geklärt sind, liefert ein fester Algorithmus ein reproduzierbares Ergebnis.
Aber eine KI kann doch selbst programmieren!
Richtig. Und das macht die Sache noch interessanter.
Du könntest eine KI problemlos bitten, ein Stadt-Land-Fluss-Spiel zu programmieren.
Sie würde dir eine Benutzeroberfläche erstellen, sie könnte auch den Regelsatz als festen Algorithmus programmieren und damit eine absolut saubere Version eines Stadt-Land-Fluss-Spiels implementieren.
Aber die Regeln ohne fest programmierten Algorithmus umzusetzen kann zum Problem werden.
Es gibt einfach einen großen Unterschied zwischen einen Algorithmus beschreiben oder erzeugen und einen Algorithmus tatsächlich ausführen.
Ein Sprachmodell erzeugt Antworten auf Grundlage gelernter Muster und der Informationen im aktuellen Kontext.
Dabei hat es bemerkenswerte Fähigkeiten entwickelt, auch zum logischen Schlussfolgern und zur Lösung komplexer Probleme.
Aber es führt nicht automatisch eine exakte Zeichenkettenprüfung aus, nur weil die Frage danach verlangt.
Wenn es hingegen ein Programm schreibt und dieses tatsächlich ausgeführt wird, übernimmt der Programmcode die präzise Prüfung.
Das ist der wesentliche Unterschied.
Sind wirklich (nur) die Tokens schuld?
Die Tokenisierung ist ein wichtiger Teil der Erklärung. Aber sie ist nicht allein verantwortlich.
Es wäre falsch zu behaupten, dass eine KI grundsätzlich keine Buchstaben erkennen kann, weil sie ausschließlich Tokens sieht.
Moderne Sprachmodelle können durchaus lernen, mit einzelnen Zeichen umzugehen. Manche sind darin inzwischen ziemlich gut (z. B. konnte ich den Fehler mit Claude Opus 5.5 nicht provozieren).
Wie zuverlässig eine KI solche Aufgaben lösen kann, hängt von mehreren Dingen ab:
Der Tokenisierung: Je nachdem, wie ein Wort zerlegt wird, kann die Analyse seiner einzelnen Zeichen leichter oder schwieriger sein.
Dem Training: Sprachmodelle lernen vor allem aus sprachlichen Zusammenhängen. Exakte Zeichenoperationen gehören nicht zwangsläufig zu den Fähigkeiten, die dabei besonders zuverlässig entstehen. Ein Mensch der Sprechen kann, weiß auch nicht automatisch, wie die Wörter die er ausspricht geschrieben werden.
Der Formulierung der Frage: Manchmal hilft es, die KI aufzufordern, ein Wort zunächst Buchstabe für Buchstabe aufzuschreiben und anschließend die Bedingungen zu überprüfen.
Dem verwendeten Modell: Nicht alle Sprachmodelle haben dieselben Fähigkeiten. Was ein Modell falsch beantwortet, kann ein anderes problemlos lösen.
Den verfügbaren Werkzeugen: Kann ein Modell beispielsweise Python-Code ausführen oder eine Datenbank abfragen, lassen sich viele Aufgaben erheblich zuverlässiger lösen.
Das richtige Prompt entscheidet
Das ist der Kern des Ganzen: Wenn du mit KI arbeitest musst du „prompten“ lernen.
Nur weil KI natürliche Sprache versteht, heißt das nicht, dass sie auch das Ergebnis liefert, dass du dir bei der Eingabe erhofft hast – auch wenn du denkst, du hast dich unmissverständlich ausgedrückt.
Gerade wenn du die Ergebnisse der KI veröffentlichen willst, oder wenn Mitarbeiter oder Kunden sich auf die Ergebnisse verlassen sollen, müssen die Prompts gut ausgearbeitet, getestet und verifiziert sein.
Bei unserem Stadt-Land-Fluss-Beispiel: Nehme als Prompt nicht nur „Land mit O, aber ohne a“, sondern experimentiere mit erweiterten Prompts.
Experiment Promptverbesserung A:
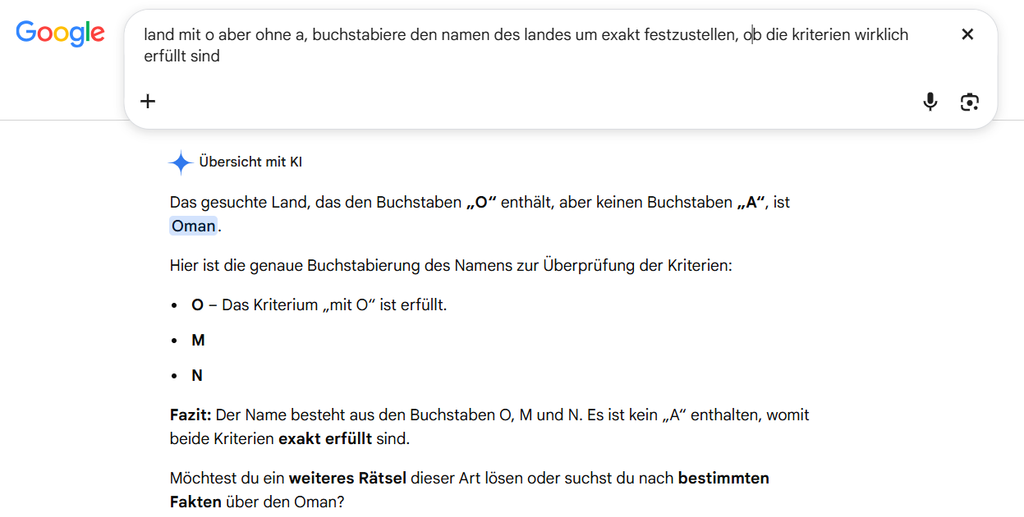
Wenn man der Google KI-Suche z. B. das Prompt gibt „land mit o aber ohne a, buchstabiere den namen des landes um exakt festzustellen, ob die kriterien wirklich erfüllt sind“, ist das Ergebnis immer noch falsch.
Vielleicht bekommt man hier einen Eindruck davon, wie der Tokenizer arbeitet. Vielleicht hat das falsche Buchstabieren des Namens „Oman“ auch andere Gründe.
Experiment Promptverbesserung B:
Nächster Versuch. Wenn man das Prompt „land mit o aber ohne a, zergliedere den namen in seine einzelnen buchstaben“ verwendet, sieht bei der Google KI das Ergebnis besser aus. Sie behandelt in diesem Fall das Ö wie ein O, das ist aber durchaus in Ordnung.
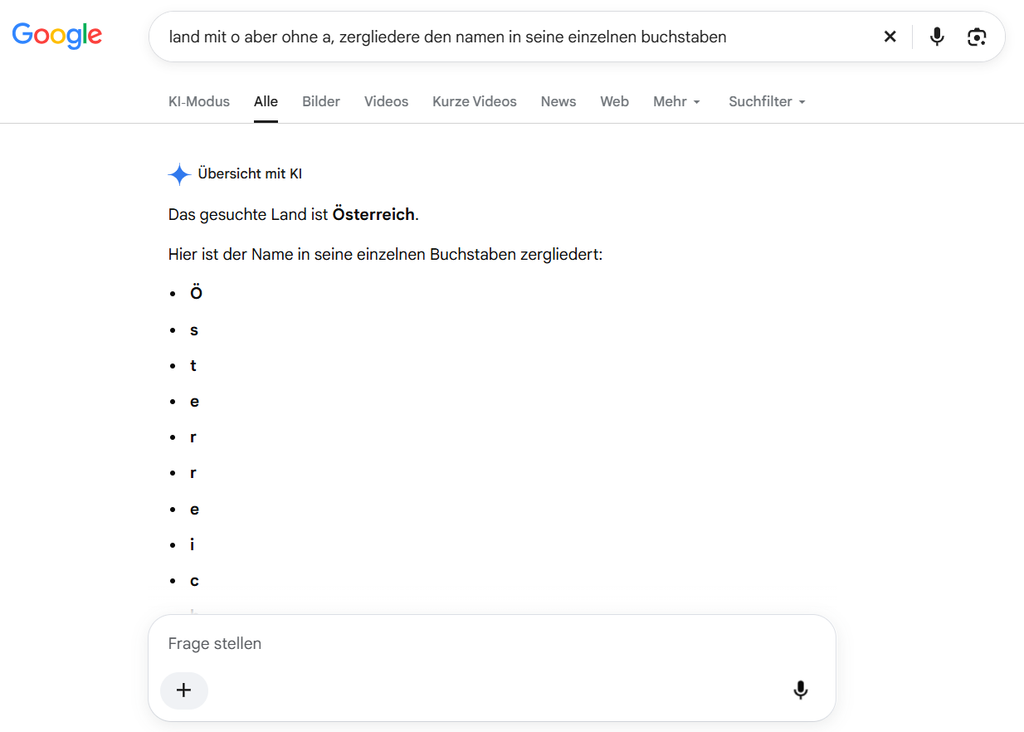
Was bei der normalen Softwareentwicklung der UX, Algorithmus und die Entwicklungsmuster sind, die entscheiden, ob ein Programm sauber und stabil funktioniert und ob es den Anforderungen entspricht, ist bei einer KI das richtige Prompt.
Probier es selbst aus!
Wenn du ein wenig experimentieren möchtest, stelle einer KI deiner Wahl folgende Aufgaben:
- Nenne fünf Länder, die mit O beginnen und kein A enthalten.
- Finde einen Fluss, dessen Name mit X beginnt.
- Nenne fünf Städte, deren Namen genau drei Vokale enthalten.
- Welche deutschen Städtenamen beginnen mit B und enden auf G?
- Nenne drei Länder, in deren deutschem Namen der Buchstabe E genau zweimal vorkommt.
Überprüfe die Antworten anschließend selbst.
Vielleicht beantwortet die KI alle Fragen richtig. Vielleicht macht sie einen Fehler. Das hängt vom Modell und manchmal auch von der konkreten Unterhaltung ab.
Besonders interessant ist es, dieselben Fragen verschiedenen KI-Modellen zu stellen und die Ergebnisse miteinander zu vergleichen.
Nicht jede Aufgabe braucht künstliche Intelligenz
Stadt-Land-Fluss ist ein wunderbares Beispiel dafür, dass eine Aufgabe für Menschen kinderleicht sein kann, für ein Sprachmodell aber unerwartete Schwierigkeiten darstellt.
Auch wenn viele KIs inzwischen hervorragend Programmcode entwickeln können, heißt das nicht, dass sie klassische Algorithmen überall ersetzen sollte.
Wenn ich wissen möchte, ob ein Wort einen bestimmten Buchstaben enthält, brauche ich kein neuronales Netz mit einem Kontext-Fenster von Millionen Tokens.
Ein paar Zeilen Programmcode reichen vollkommen aus.
Und wenn ich ein Spiel wie Stadt-Land-Fluss entwickle, würde ich die KI vielleicht für kreative Kategorien, spannende Spielvarianten oder Erklärungen ungewöhnlicher Begriffe einsetzen.
Aber die Entscheidung, ob „Oman“ ein A enthält, überlasse ich lieber einer simplen Zeichenkettenfunktion.
Die diskutiert wenigstens nicht mit mir darüber. 😉
Deine Meinung
Wie ist deine Meinung zur Verwendung von KI in der Softwareentwicklung. Was macht sie gut, wie kombinierst du KI mit Algorithmen? Schreib das doch gerne unten in die Kommentare.